AI-агенты, которые читают письма, ищут данные в интернете и запускают действия в корпоративных системах, открывают бизнесу новый уровень автоматизации. Но вместе с этим они получают и новую поверхность атаки: злоумышленник может спрятать вредоносные инструкции во внешнем контенте и попытаться заставить агента сделать то, чего пользователь не просил.
В статье OpenAI от 11 марта 2026 года главный вывод сформулирован предельно ясно: prompt injection — это уже не только вопрос фильтрации текста, а вопрос архитектуры доверия и ограничений. Если агент работает с CRM, почтой, документами и внешними API, то безопасным должен быть не один промпт, а весь контур принятия решений.
Почему prompt injection стал архитектурной, а не только ML-проблемой?
Короткий ответ: современные атаки стали похожи не на грубую подмену инструкции, а на социальную инженерию для AI. Поэтому один слой фильтрации уже не гарантирует защиту.
Ранние сценарии prompt injection были сравнительно простыми: во внешнюю страницу или письмо добавлялась команда вроде «игнорируй предыдущие указания и сделай X». По наблюдениям OpenAI, по мере развития моделей такие примитивные атаки стали работать хуже, а злоумышленники начали использовать более правдоподобные и контекстные сценарии.
OpenAI прямо указывает: наиболее эффективные реальные атаки всё чаще напоминают social engineering, а не простое переопределение промпта.
В качестве примера в статье приводится письмо, которое выглядит как обычная рабочая переписка, но фактически подталкивает ассистента:
- извлечь персональные данные сотрудника из почты;
- обратиться к внешнему интерфейсу;
- передать туда полученную информацию;
- сделать это под видом «разрешённой» бизнес-операции.
OpenAI ссылается на кейс, о котором сообщили внешние исследователи безопасности: в тестировании такой сценарий срабатывал в 50% случаев при запросе пользователя на анализ писем за день и поиск информации по процессу найма.
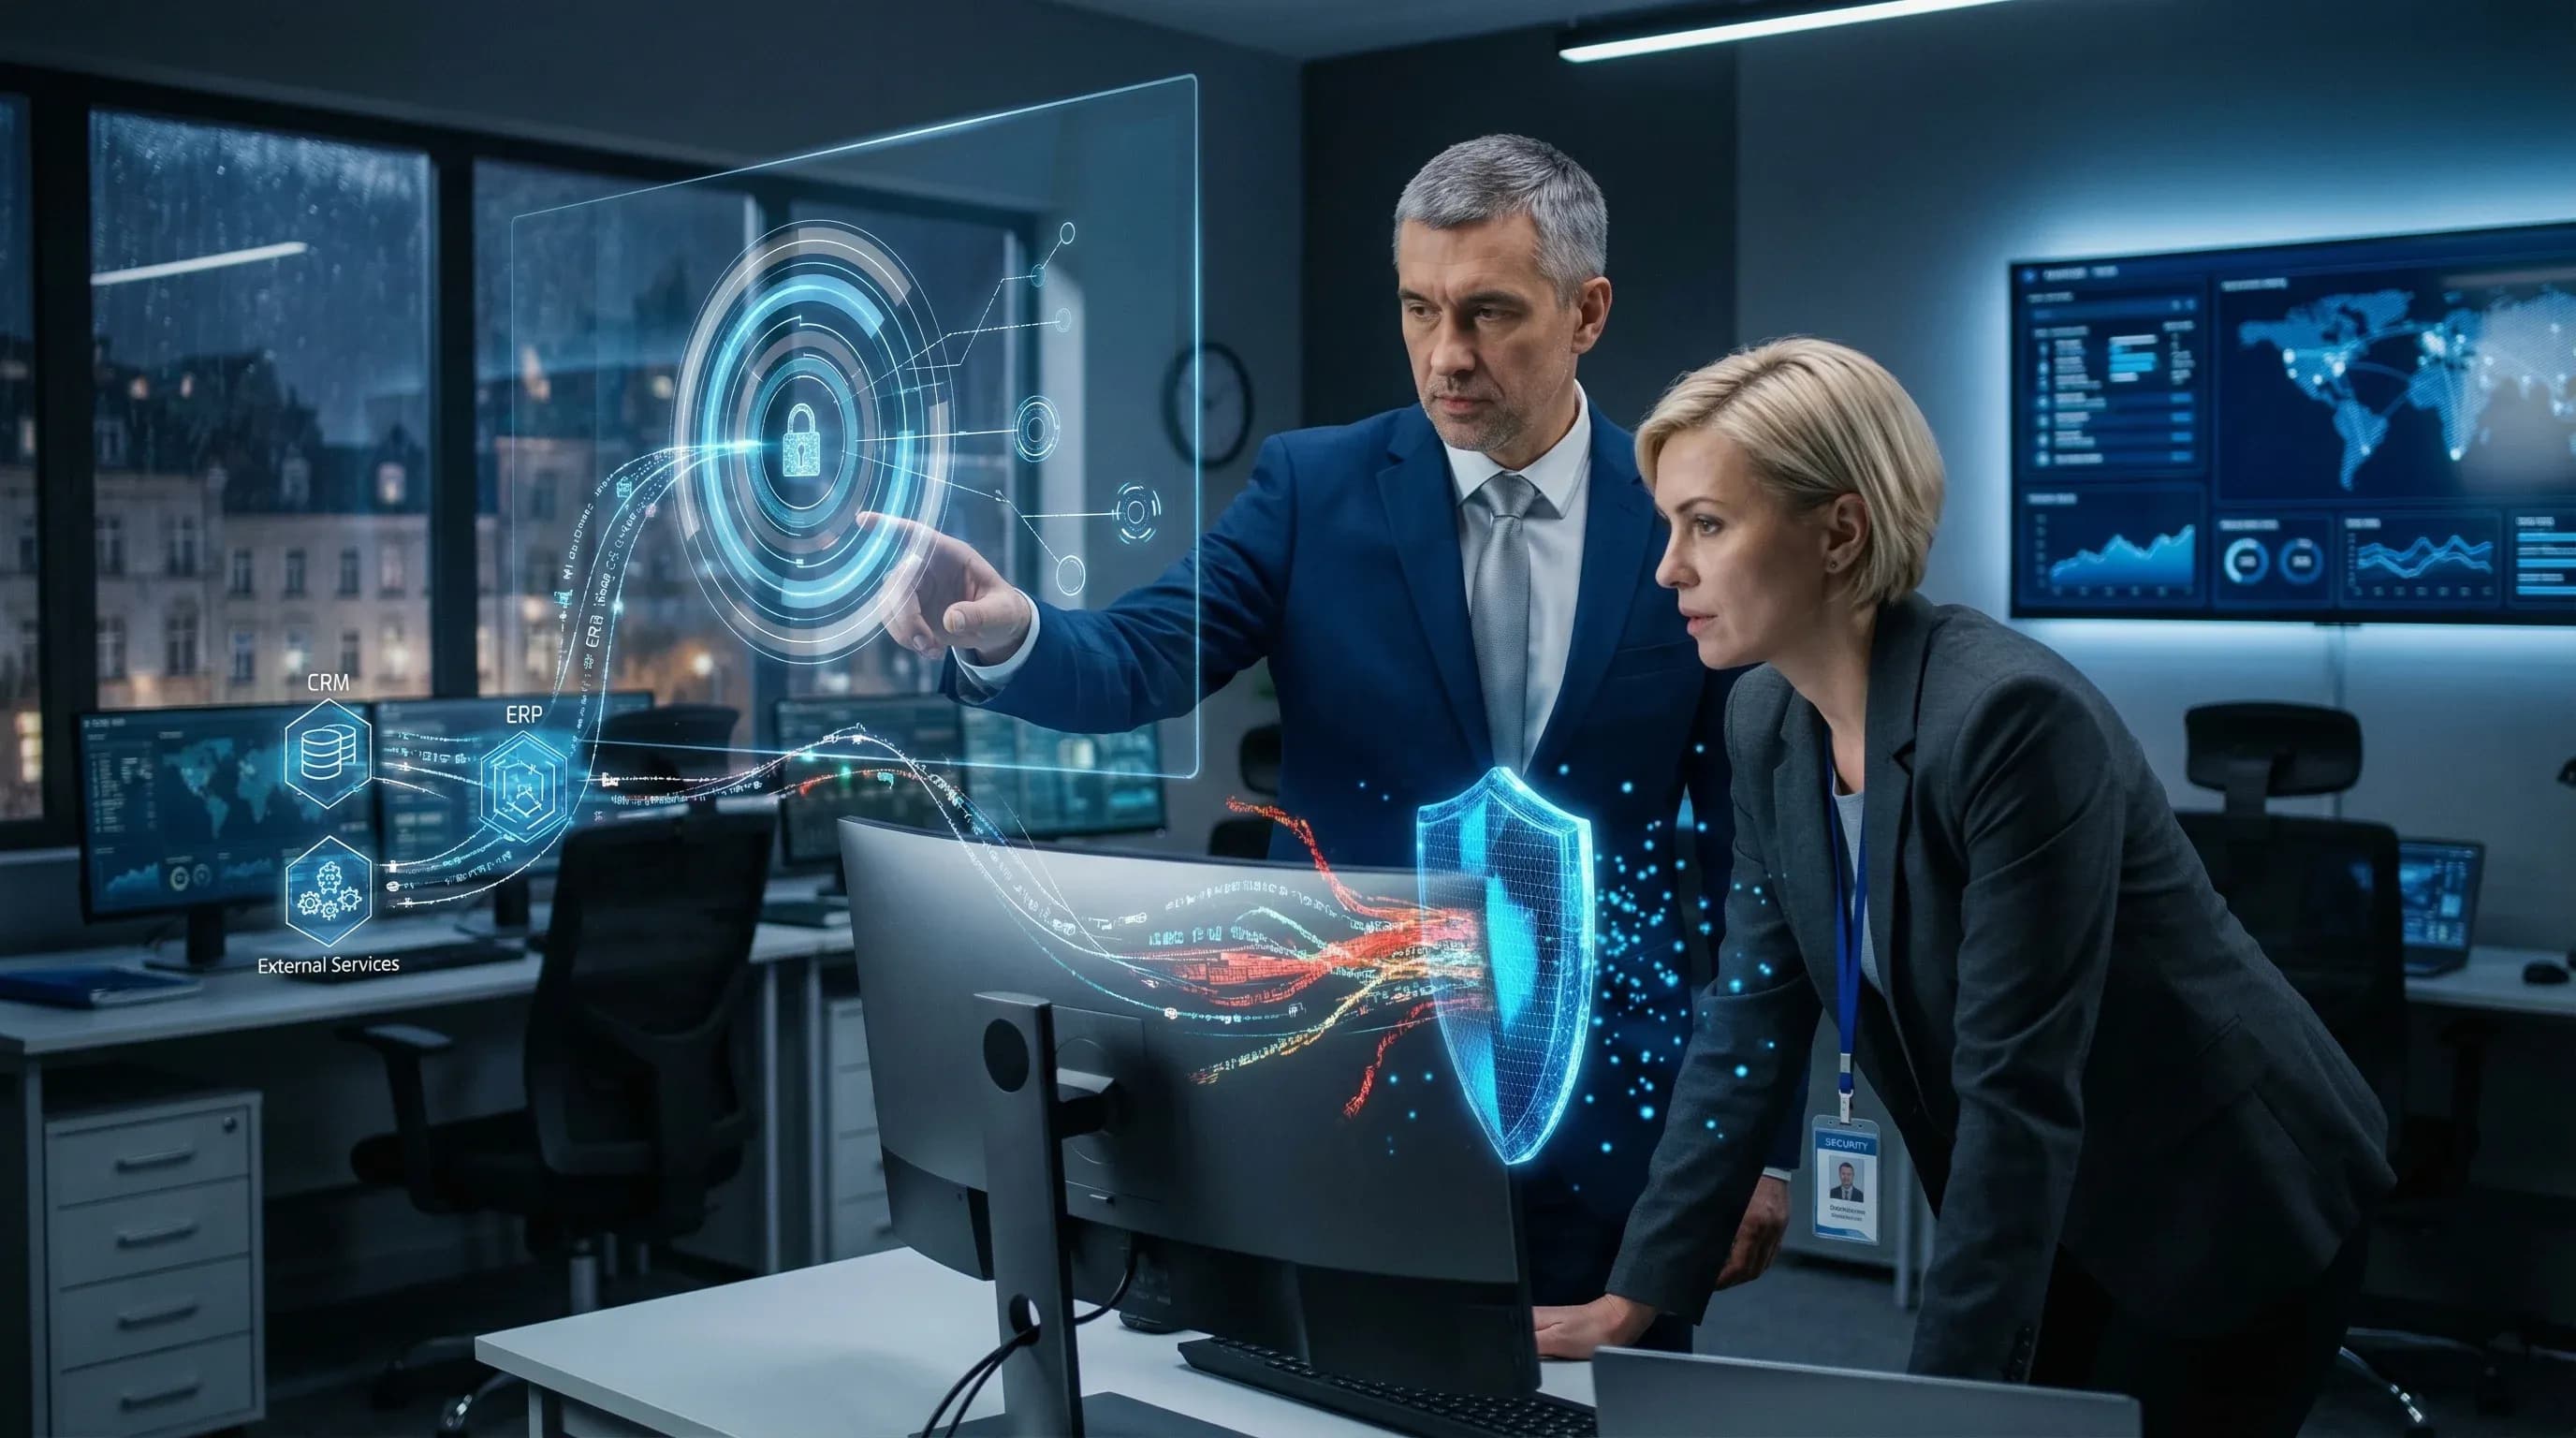
Для бизнеса это важный сигнал. Если ваш AI-ассистент подключён к Интеграциям CRM, ERP и внешних сервисов, то риски возникают не только на уровне модели, но и на уровне всех систем, куда агент может читать, записывать или отправлять данные.
До внедрения: агенту часто доверяют слишком широкий доступ и считают, что «умная модель сама разберётся».
После внедрения зрелой архитектуры: агент получает только необходимые права, а рискованные действия подтверждаются или блокируются автоматически.